



Зміст:

Дата публікації: 10.11.2026
Переглядів: 7
Коли наша команда взялася за 3PL-систему (third-party logistics) для складських операцій у США, ми з першого дня зробили Claude Code головним агентом для написання коду. Нам хотілося перевірити, наскільки далеко може зайти проєкт з нуля, якщо працювати на основі специфікацій. Приблизно за 3 місяці система вже працювала в продакшені, хоча на проєкт такого масштабу, написаний вручну, нам зазвичай потрібно близько 6 місяців.
Здебільшого цей виграш забезпечила розробка на основі специфікацій. Кожна задача надходила агентові разом із перевіреним контекстом проєкту та чіткими правилами реалізації й приймання. Швидший темп змінив і роль розробника: його увага змістилася на архітектуру та перевірку результатів, а особисте розуміння згенерованого коду стало поверхневішим. Цей компроміс ми детально розглянемо далі.
Нижче розповідаємо, як ми готували контекст і організовували роботу, як проходило тестування, де виникали збої і які практики плануємо зберегти в наступних проєктах.
| Проєкт | 3PL-система для складських операцій у США, створена з нуля |
| Основні інструменти | Claude Code для реалізації, друга ШІ-модель для незалежної перевірки документів і розбиття на задачі |
| Підхід | Розробка на основі специфікацій, картки задач зберігаються в репозиторії |
| Терміни | Близько 3 місяців від архітектури до продакшну |
| Статус | Запущено в продакшн |
Що входить до 3PL-системи
Система охоплює всю роботу клієнта зі складом: від першого постачання товару до виставлення рахунків та оплати. Вона складається з 13 модулів, назви яких подано так, як в інтерфейсі:
| Модуль | Що охоплює |
| Dashboard | Огляд облікового запису клієнта та поточної активності |
| Products | Каталог товарів клієнта |
| Inbound Shipments | Постачання товару на склад |
| Inventory | Поточні залишки на складі |
| Product report | Звіти за товарами клієнта |
| Orders | Замовлення покупців, які виконує склад |
| Stores | Підключені сторонні магазини |
| Import orders | Замовлення, що надходять через API з інших платформ, наприклад Shopify |
| Returns | Товари, повернуті на склад |
| Disposal | Утилізація товару, який більше не потрібен клієнтові |
| Invoices | Рахунки за складські послуги |
| Payments | Оплата рахунків безпосередньо в системі |
| Balance | Баланс облікового запису клієнта |
Чому знадобився інший підхід
Генерація коду за допомогою ШІ стала стандартною практикою в розробці програмного забезпечення. Мало хто з команд досі пише кожен рядок вручну, і дедалі більша частка коду з’являється завдяки ШІ-агентам, які працюють під керівництвом інженера. Для нас питання полягало в тому, як ефективно застосувати ШІ у великому проєкті.
Нова система потребує десятків узгоджених рішень щодо модулів, яких ще не існує: структури шарів, моделей даних, формату API, правил тестування. Агент, який бачить лише поточну задачу, ухвалює рішення, логічні в її межах, але згодом вони конфліктують між собою.
Головним викликом було дати агентові повну і стабільну картину системи. Це вирішила розробка на основі специфікацій: правила проєкту зберігаються у файлах, які агент читає на початку кожної сесії, тож його робота не залежить від попередніх чатів.
Як ми зібрали контекст для агента
Ще до написання коду ми зібрали матеріали, потрібні агентові, щоб зрозуміти бізнес клієнта та наші технічні стандарти. Вони надійшли з трьох джерел:
- Бізнес-вимоги. Технічне завдання на 3PL-систему з бізнес-логікою та функціональними сценаріями складських процесів, які вона має підтримувати.
- Наші перевірені компоненти. Готові модулі та пакети, які ми використовуємо для окремих функцій, від правил побудови шарів до стандартних можливостей.
- Проєктна документація. Агент мав доступ до джерел проєкту, зокрема до документації в Confluence, що доповнило його контекст деталями щодо вимог та ухвалених рішень.
На основі цих джерел ми підготували два ключові документи, на які спирається кожна наступна сесія агента:
- architecture.md: шари, класи, правила тестування, формат відповідей API та загальний каркас проєкту.
- spec_db.md: повна структура бази даних.
Кожен ШІ-інструмент мав чітку роль:
| Інструмент | Роль у проєкті |
| Claude Code | Вивчив наші компоненти та пакети, після чого реалізовував задачі |
| Друга модель із розширеним режимом міркування (ChatGPT) | Допомагала узгоджувати документацію та звіряла розбиття на задачі зі специфікацією |
Два дні, які визначили напрям
Початкове проєктування архітектури та планування задач зайняли приблизно 1–2 дні. Кожен важливий результат ми уточнювали та вручну перевіряли, перш ніж рухатися далі.
architecture.md
Спираючись на специфікацію та наші компоненти, агент описав шари, класи, правила тестування, формат відповідей API та загальний каркас. Перша версія містила помилку проєктування: агент запропонував окремий клас-менеджер майже для кожного методу контролера. Ці та інші неточності ми виправили за кілька ітерацій перевірки.
spec_db.md
В окремому чаті ми побудували повну структуру бази даних на основі вихідних матеріалів і затвердженої архітектури. До початку реалізації схема пройшла кілька генерацій і доопрацювань.
Великі картки задач
Увесь обсяг робіт ми розбили приблизно на 24–25 доменних або функціональних задач, кожна з яких мала 5–7 підзавдань. Перша версія вийшла надто деталізованою, тому ми кілька разів переглядали план, коригували промпт і переробляли структуру та зміст карток, доки не отримали фінальний варіант.
Окремо ми стежили за тим, щоб задачі відповідали специфікації. Друга модель у розширеному режимі міркування незалежно перевірила картки та підзадачі.
Наприкінці цього етапу архітектурні домовленості були зафіксовані письмово, а агент отримав план, якого дотримувався до завершення проєкту.
Модель задач, що живе в репозиторії
План перенесли безпосередньо в репозиторій. Теки backlog, active і completed відстежували стан як великих задач, так і їхніх підзавдань. Картка великої задачі описувала обсяг робіт, а детальні картки підзадач пояснювали, як її реалізувати та як прийняти результат.
tasks/
├── backlog/
├── active/
│ ├── domain-task/
│ │ ├── task-card.md
│ │ ├── backlog/
│ │ │ ├── 01-....md
│ │ │ └── 02-....md
│ │ ├── active/
│ │ └── completed/
│ └── quicktasks/
│ ├── fix-a.md
│ └── fix-b.md
└── completed/
Структура наведена для ілюстрації, назви файлів умовні.
Ми працювали з трьома типами карток:
| Тип картки | Що містить |
| Велика задача | Домен або великий функціональний блок. Картка в її основі описує очікуваний результат і перелік запланованих підзавдань. |
| Підзадача | Створюється окремим промптом. Має визначений обсяг, залежності, правила реалізації та критерії приймання. |
| Швидка задача | Невелике виправлення бізнес-логіки в окремій картці, без декомпозиції. Після приймання переходить у completed. |
Кожна картка підзадачі містила мету та посилання на відповідні частини architecture.md, spec_db.md і специфікації. Критерії приймання визначали необхідні тести, перевірки API та документацію.
Задача змінювала статус лише після того, як ми перевірили її результат на практиці. Завдяки цьому тривалий процес розробки залишався послідовним, а роботу було легко продовжити в новій сесії.
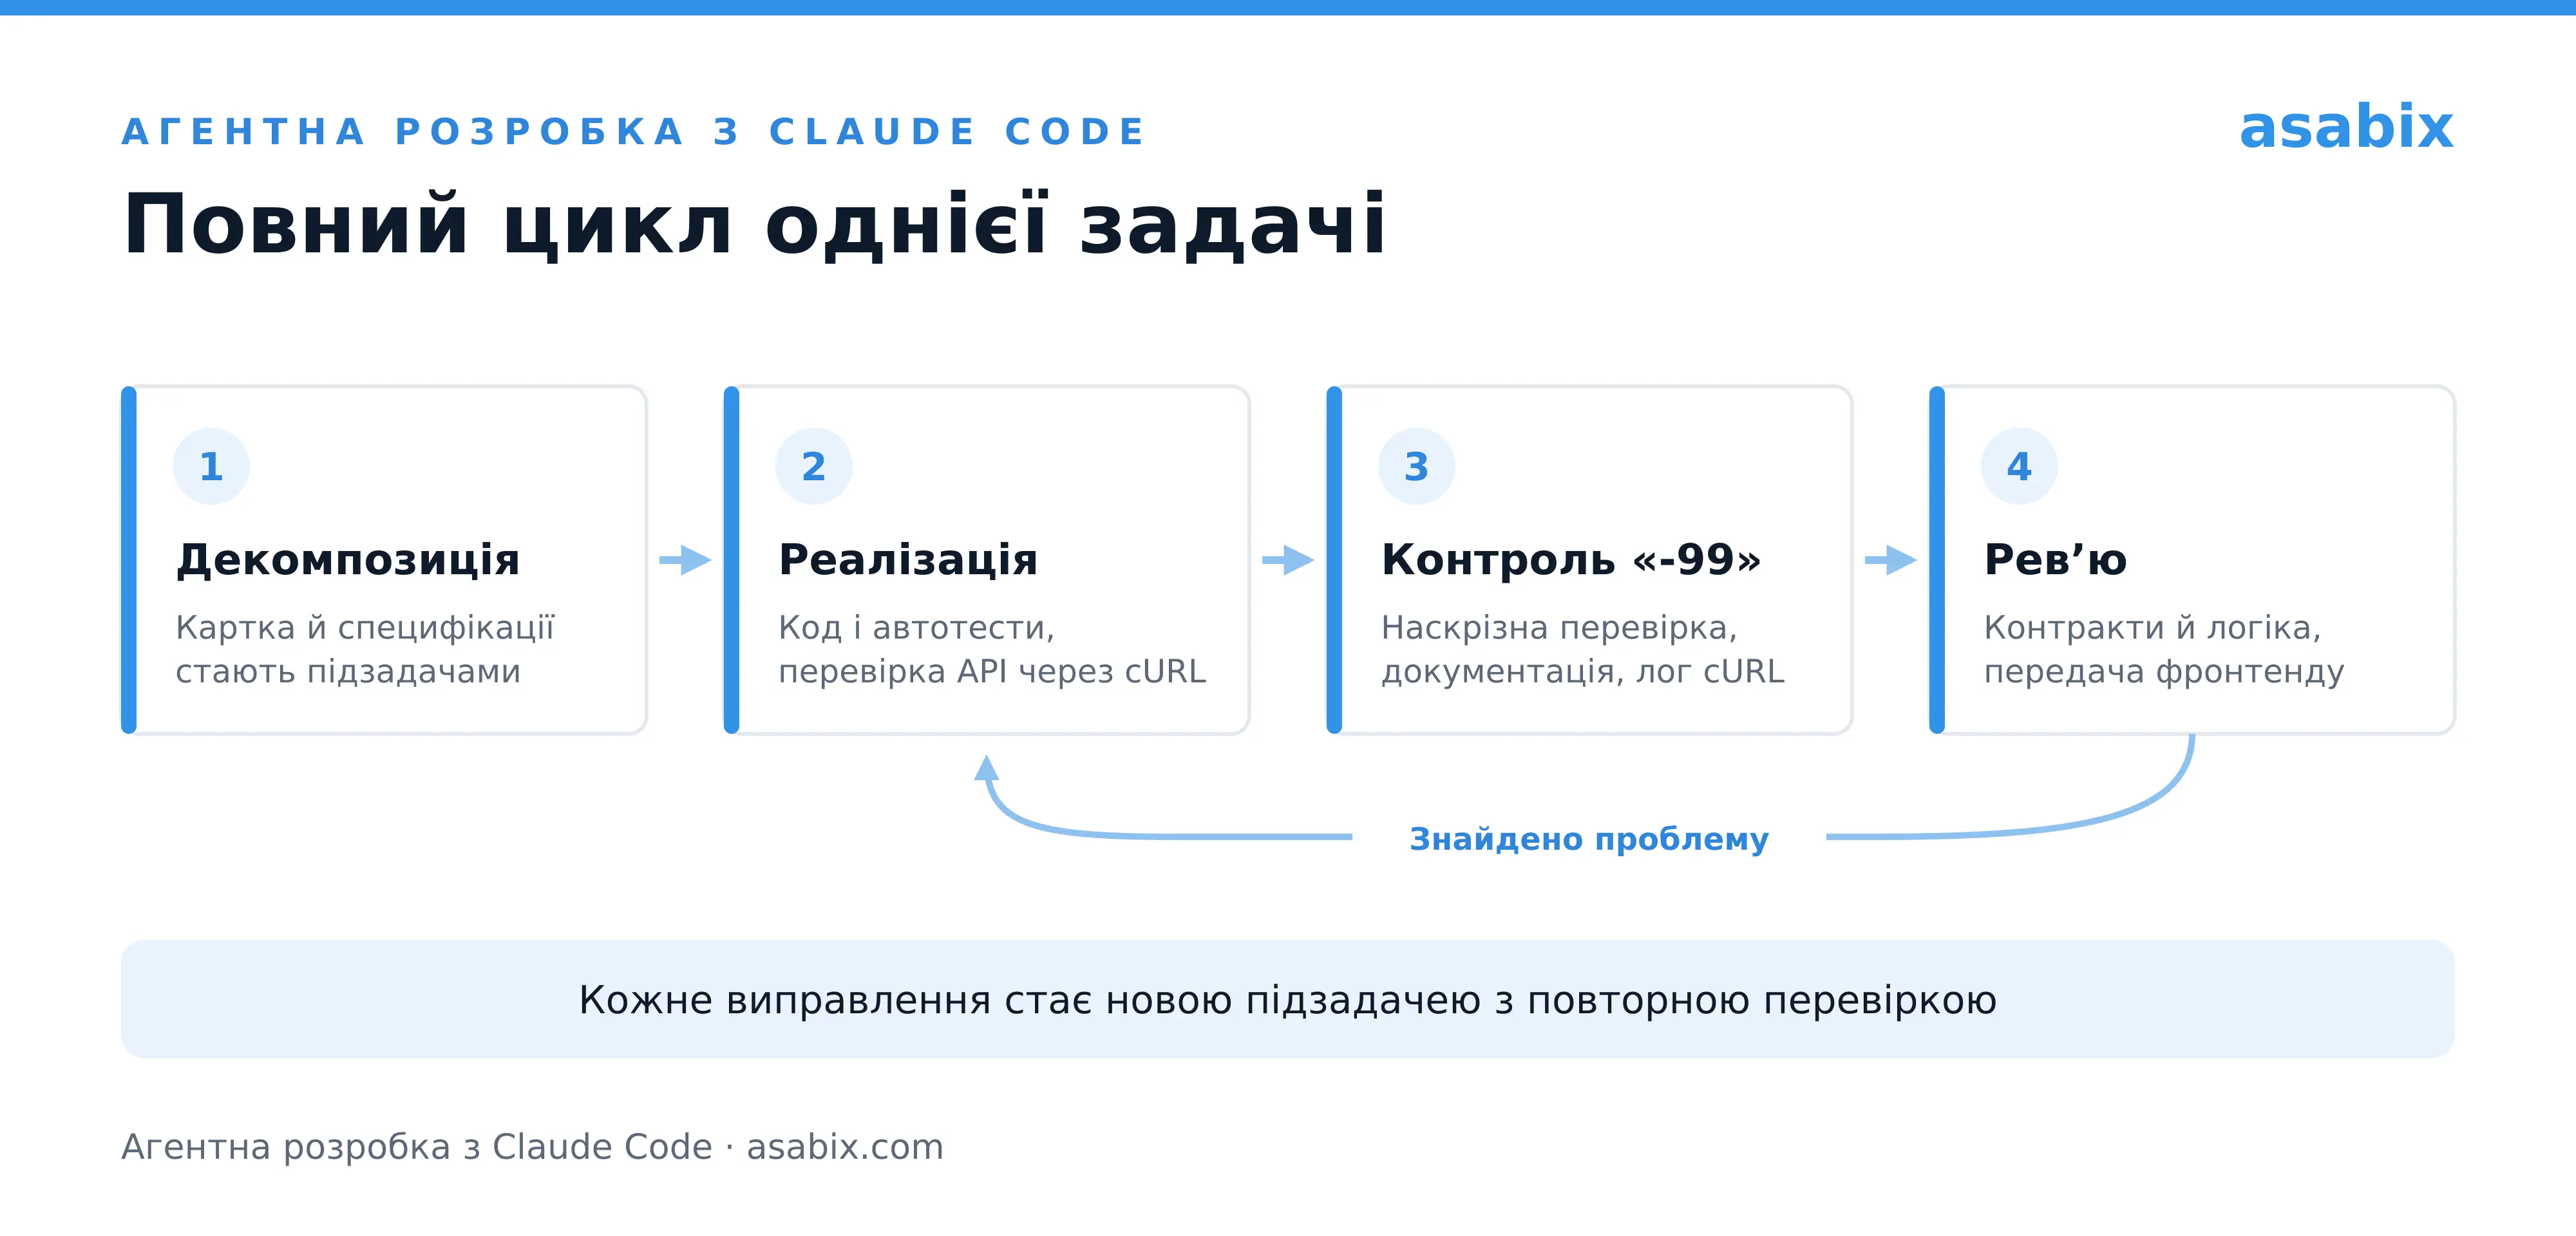
Повний цикл однієї задачі
Кожна велика задача проходила ті самі чотири кроки, а кожну підзадачу виконували окремо відповідно до її специфікації та критеріїв приймання.
- Декомпозиція. Перший промпт поєднував картку задачі, architecture.md і spec_db.md та перетворював велику картку на готові до виконання картки підзавдань.
- Реалізація. Підзадачі по черзі переходили в активний стан. Агент писав код разом із юніт- і функціональними тестами, а нові API-ендпоінти перевіряв за допомогою cURL.
- Контрольний крок «-99». Фінальна підзадача з номером «-99» виконувала наскрізну перевірку всієї задачі та формувала два звіти.
- Перевірка та завершення. Після перевірки контрактів API і бізнес-логіки ми переносили задачу в completed і передавали її фронтенд-команді.
Крок «-99» давав два результати:
- Документація для фронтенду: контракти API та очікувані відповіді, а також опис бізнес-логіки в її фінальному вигляді.
- Журнал перевірок cURL: конкретні запити до локального середовища з payload, HTTP-відповідями та результатами.
Якщо під час перевірки виявляли проблему, виправлення здійснювалося тим самим шляхом: створення нової картки підзадачі, її реалізація, повторна перевірка та оновлення документації.
Перевірки зосереджувалися здебільшого на API-контрактах і бізнес-сценаріях. Це забезпечувало надійний результат, проте повне розуміння розробником згенерованої реалізації стало окремим ризиком, про який ідеться нижче.
Автоматизоване тестування: де воно допомагає і де його межі
Claude Code самостійно генерував юніт- та функціональні тести та виконував HTTP-перевірки за допомогою cURL. Це скоротило ручну роботу з API, і в багатьох сценаріях Postman був потрібен значно рідше. Ціна цього проявилася пізніше, коли тестовий набір розрісся і його довелося запускати.
Ми проводили перевірки на трьох рівнях:
| Рівень | Що запускається |
| Підзадача | Відповідні автотести та запити до API |
| Задача (крок «-99») | Фінальна наскрізна перевірка та звіт cURL |
| Повна регресія | Увесь набір тестів |
Повна регресія стала вузьким місцем: один повний прогін тривав кілька годин.
Інциденти під час роботи
- Переповнення диска. Тести генерували стільки PDF-файлів, що диск заповнився і Claude Code зупинився.
- Втрата локальної бази даних. Під час деяких прогонів тестів агент видалив локальну базу даних.
- Конфлікти агентів. Кілька агентів, що працювали паралельно, втручалися в спільне середовище й заважали один одному.
Серйозних помилок у самій бізнес-логіці ми не виявили. Найпомітніші збої стосувалися тестової інфраструктури та взаємодії агентів зі спільним станом.
Чому специфікації критично важливі
Агент обмежений своїм робочим контекстом і не зберігає повного розуміння системи між сесіями. Документація стала для нас способом відновити задум проєкту без повторного читання всієї кодової бази. Водночас застарілі специфікації можуть зашкодити більше, ніж їхня повна відсутність.
Дрібні ранні помилки дорого коштують
На старті різниця між двома рішеннями здається мінімальною. Коли на їхній основі вже побудовано залежні модулі, зміна типу поля чи межі шару може вимагати значної переробки. Нам допомогли дві практики:
- Синхронізувати специфікації з кодом. Будь-яка зміна від клієнта, що зачіпає структуру чи бізнес-правила, оновлює architecture.md і spec_db.md разом із кодом.
- Фіксувати причини рішень. Пояснювальні коментарі в коді можуть зберегти, чому обрано неочевидне рішення і якої помилки варто уникати майбутнім сесіям агента. Ефект цієї практики ми ще не вимірювали.
Технічний борг, за яким варто стежити
Попри виправлену на старті помилку проєктування, шар менеджерів усе одно вийшов надто великим. Його варто переглянути на рівні архітектури й, можливо, відрефакторити.
Моделі та межі автономії
Увесь підхід працював на стандартних промптах і специфікаціях у файлах, без власних інструментів.
| Період | Основний режим | Як використовувався |
| Перші 2 місяці | Sonnet, середній рівень міркування | Основна реалізація. Opus відповідав за декомпозицію, складні рішення та періодичний аналіз коду. |
| Останній місяць | Sonnet, низький рівень міркування | Основна генерація коду в економному режимі, щоб вкластися в тижневі ліміти використання. |
Чітка межа для Git і сервера
| Агент | Розробник |
| Читав стан Git | Створював гілки |
| Генерував і змінював код | Робив коміти та push у репозиторій |
| Запускав локальні перевірки | Підключався до сервера та виконував git pull |
Агентові заборонялися будь-які дії в Git, що змінюють стан. Розгортання та керування репозиторієм залишалися повністю ручними.
Результати
Усі ключові функції 3PL-системи працюють у продакшені. Від архітектури до релізу проєкт тривав близько 3 місяців. З огляду на наш досвід зі схожими системами, вручну на нього пішло б приблизно 6 місяців, тож агентний підхід скоротив час розробки приблизно вдвічі.
Великі задачі також просувалися значно швидше:
| Сценарій | Типова тривалість складної задачі |
| До агентного підходу | Тиждень і більше |
| 3PL-проєкт із Claude Code | 1–3 дні |
Більша частина зусиль змістилася з написання коду на формування проєкту: проєктування архітектури, доопрацювання специфікацій, підготовку карток задач і перевірку результатів.
Де підхід спрацював найкраще
- Нові проєкти: максимальний ефект. Система з нуля, де архітектуру й базу даних описано заздалегідь, а великі задачі розбито на підзадачі.
- Наявні проєкти: помірніший ефект. Виправлення та невеликі функції на основі окремих карток специфікацій. Агент вивчав код у процесі роботи, без нового набору архітектурних документів.
Ці цифри ґрунтуються на одному проєкті та власній оцінці нашої команди, без контрольованого бенчмарку.
Компроміс: швидша розробка, поверховіше розуміння
Пришвидшення розробки мало ціну, важливішу за будь-які показники термінів: розробник став гірше розуміти код.
Розробник увесь час контролював процес — від написання промптів до прийняття кожної задачі. Проте перевірка коду працює інакше, ніж його написання. Коли пишеш код сам, у голові вибудовуються причинно-наслідкові зв’язки: навіщо існує клас і що зламається, якщо його змінити. Перевірка дає поверхневе знайомство з кодом, і деякі деталі чи зв’язки можуть залишитися непоміченими.
Розробник, який читає згенеровані класи, розуміє кожну окрему частину, але йому може бути складно пояснити всі зв’язки та повний шлях виконання. Таку втрату наскрізного володіння кодом ми вважаємо реальним ризиком і контролюємо її за допомогою регулярних розборів коду та архітектурних рев’ю.
Практичні правила агентної розробки
Ці правила підсумовують те, що ми перенесемо в наступний агентний проєкт. Більшість із них стосується роботи з генерацією коду, адже саме вона визначила якість цього проєкту.
- Ретельно проєктуйте систему. Документація, архітектура, схема бази даних і картки задач потребують ґрунтовної перевірки. Помилка, допущена на старті, коштує значно дорожче, коли на ній уже побудовано десятки задач.
- Контролюйте тести та розділяйте прогони. Перевіряйте, які тести створює агент. Для частих запусків використовуйте швидкі смоук-тести й точкові перевірки, а глибоку перевірку плануйте як окремий прогін.
- Вчасно помічайте потребу в рефакторингу. Регулярно переглядайте згенерований код і межі шарів. Невдале рішення простіше виправити одразу, ніж після десяти пов’язаних задач.
- Зберігайте розуміння критичного коду. Після кожного великого етапу проходьте ключові сценарії та синхронізуйте специфікації з кожною зміною.
- Захищайте тестове середовище. Ізолюйте тестову базу даних і обмежте кількість файлів, які створюють тести. Надавайте паралельним агентам окремі середовища, щоб перевірки не пошкоджували спільний стан.
Висновок
Якість агентної розробки залежить насамперед від рішень, ухвалених ще до генерації коду. У цьому проєкті агентний підхід скоротив час розробки з орієнтовних 6 місяців до 3 і допоміг нам запустити 3PL-систему в продакшн. Ціною стало поверхневе особисте розуміння коду, і цей ризик ми тепер свідомо контролюємо.
Найбільша відповідальність лежить на етапі проєктування. Актуальні специфікації та регулярна перевірка коду дають команді змогу використовувати швидкість агента, не накопичуючи помилок, виправлення яких згодом обходиться дорого.
Давайте обговоримо ваш проєкт
Блог
#0000
Читайте також інші статті в нашому блозі
Скільки коштує створити сайт?
08 Січ, 2025
Досліджуємо, скільки коштує створення різних типів сайтів від блогу до інтернет-магазину. Оцінюємо вплив складності дизайну та функціоналу на остаточну вартість проєкту.
ПЕРЕГЛЯНУТИ СТАТТЮ

Аутсорс та аутстаф: різниця та особливості
20 Лип, 2023
Сучасні компанії зіштовхуються з потребою швидкого та ефективного розроблення програмного забезпечення та інших ІТ-проєктів.
ПЕРЕГЛЯНУТИ СТАТТЮ

Що таке PWA: детальна інструкція зі зразками коду
26 Лют, 2024
PWA, або Progressive Web Apps, — це вебдодатки, які поєднали в собі все найкраще з вебсайтів і мобільних додатків. Схожі на нативні за своїм функціоналом, вони працюють на будь-якому пристрої, де є веббраузери.
ПЕРЕГЛЯНУТИ СТАТТЮ
Навіщо потрібна CRM-система: поняття, переваги, різновиди
22 Лют, 2024
CRM — це програмне забезпечення для автоматизації та керування взаємодією з клієнтами. Тут в електронному вигляді зберігаються всі дані про історію замовлень та продажів, про кожного клієнта та його уподобання, а також про попередні взаємодії бренду зі споживачем.
ПЕРЕГЛЯНУТИ СТАТТЮ
